

2026年大模型训练代理IP推荐:不限量住宅代理怎么选


纯净IP推荐:静态IP低至 $1.5/个,动态IP低至 $0.5/GB


大模型训练需要海量 Web 数据,而 2026 年 AI 数据采集面对的环境已经和几年前不同:网站不再只是“反爬”,而是开始专门针对 AI crawler 做访问控制。
Cloudflare 在 2026 年进一步加强了 AI crawler 管理能力,可以区分 Search、Agent、Training 等不同类型的 AI 爬虫,并通过 Content Signals 等机制让网站声明内容是否允许用于 AI 训练。
其 Browser Rendering 服务也把训练、RAG、研究、内容监测列为明确的应用场景,并默认遵循 robots.txt 和 AI Crawl Control。
也就是说,AI 数据采集正逐渐从普通 Web scraping,变成一项独立的数据基础设施问题。
本文说明大模型训练在什么场景下需要住宅代理、什么样的任务适合不限量(按带宽计费)方案,以及怎么选。
为什么大模型训练需要住宅代理
在需要大规模访问公开 Web 数据、且目标网站存在 IP 风控或地区限制的场景下,住宅代理可以成为数据采集基础设施的一部分。
大模型训练的数据采集主要面临三个问题:
1. IP 限制
高频并发请求容易触发目标站点的速率限制,出现 429 或 403 报错。中途断连会导致数据集残缺,增加后续清洗和重跑成本。
2. 地区内容差异
训练多语言、多区域适应性的模型时,如果缺少本地网络出口,获取的网页内容可能受到地理重定向或内容屏蔽的影响。
3. 数据量巨大
预训练语料规模通常很大,采集是持续性的长期任务,成本和稳定性都比较关键。
大模型数据采集应该选哪种代理
需要注意的是:机房 IP 的网络归属通常更容易被识别。
对于部署了 IP 信誉库、Bot Management 和行为检测的网站,数据中心代理更容易触发额外验证或访问限制。
但对于公开、低风控的数据源(如政府公开数据集、学术镜像),数据中心代理的速度和成本依然有优势。
不过,住宅代理也不是万能解。
真实住宅 IP 能降低因数据中心 IP 信誉或网络归属而触发的部分限制,但实际采集效果仍取决于目标网站的 Bot Management、请求频率、浏览器环境和访问行为。
选购结论:大规模、持续性的公开 Web 数据采集,更适合采用支持 IP 轮换和高吞吐的住宅代理网络;流量较大的任务,不限量按带宽计费的方案可以进一步降低流量成本的不确定性。
为什么大模型训练适合不限量住宅代理
代理 IP 的计费模式通常分为按流量计费(Pay-per-GB)和按带宽计费(不限量 / Mbps)两种。
这里需要澄清一个常见误解:不限量不等于不限速。
不限量住宅代理通常指的是不按 GB 限制流量,而不是没有速度上限。实际吞吐能力仍取决于购买的带宽档位,还可能受到并发数、节点数量和 Fair Use Policy 等条件限制。
对于高流量的大模型数据采集,按带宽计费的不限量住宅代理有几个实际优势:
▸ 成本更可预测:按固定带宽计费,不受流量规模波动影响,长期采集更容易控制预算。
▸ 适合持续运行:不限流量避免采集过程中因流量耗尽导致管道中断,适合 7×24 小时任务。
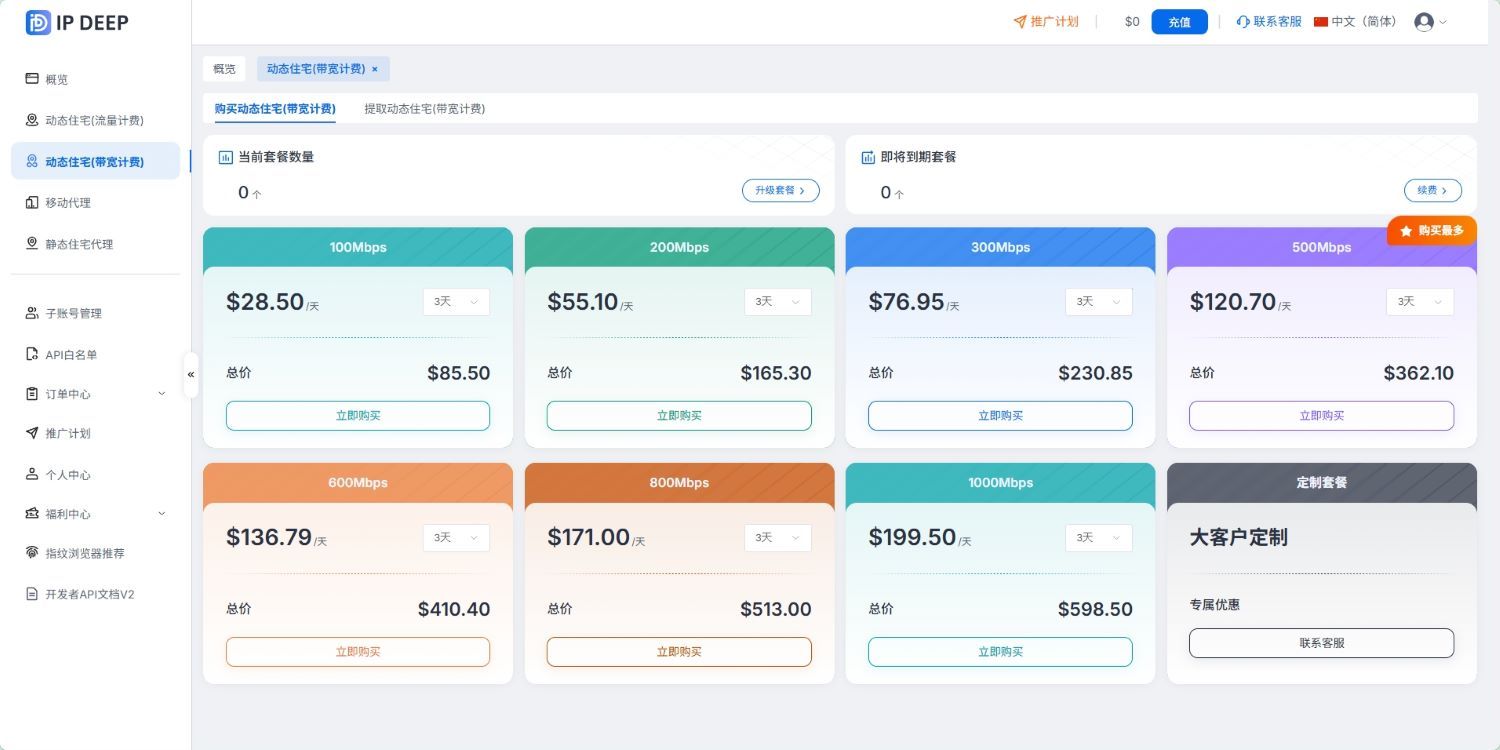
▸ 带宽可按需选择:从 100Mbps 到 1000Mbps 多档可选,按任务规模匹配。
怎么选不限量住宅代理
1. 实际带宽
根据任务的并发量和吞吐需求选择带宽档位,而不是只看“不限量”三个字。
2. IP 池和地区覆盖
关注住宅 IP 数量、地区覆盖范围,以及是否支持国家、城市级定位。
3. IP 轮换与 Sticky Session
确认是否支持按需或定时轮换 IP,以及是否支持粘性会话(用于需要连续 Session 的任务)。
4. 协议与工具兼容
支持 HTTP、HTTPS、SOCKS5,能够接入 Python Requests、Scrapy、Playwright 等常见采集工具。
5. 并发与服务稳定性
关注并发线程数支持和实际连接稳定性。延迟和成功率不建议只看服务商宣传的平均值,而应结合目标网站、目标地区和实际并发量进行测试。
实际评估时,比起单看“每 GB 多少钱”,更值得关注的是每个成功请求的实际成本。
IPDeep 不限量住宅代理
IPDeep 提供按带宽计费的不限量动态住宅代理,当前可选 100Mbps、200Mbps、300Mbps、500Mbps、600Mbps、800Mbps、1000Mbps 等多档带宽,按带宽档位计费,不按 GB 单独计费,支持按需或定时毫秒级 IP 自动轮换。
▸ 协议支持:HTTP、HTTPS、SOCKS5,适配各类爬虫框架和自动化工具。
▸ 地区覆盖:覆盖全球多个国家和地区,支持按国家、城市等维度定位。
▸ 计费模式:按带宽档位计费,流量不限,成本相对可预测。
适用于大规模网页采集、SERP 监控、AI 数据采集,以及其他需要持续高吞吐代理连接的公开数据处理场景。
如需了解具体带宽档位和当前节点,可直接访问IPDeep 官网查看。
数据采集架构建议
即使使用了优质的不限量住宅代理,合理的采集架构依然重要:
▸ 根据目标站点设置并发上限,避免触发速率限制。
▸ 对 429/5xx 响应使用指数退避(Exponential Backoff)和有限重试。
▸ 根据目标地区分别配置代理池,避免不同地区的出口混用。
▸ 对需要连续会话的任务使用 Sticky Session。
▸ 对 JS 渲染页面使用 Playwright 等浏览器环境。
▸ 使用缓存避免重复抓取。
▸ 遵守目标网站的 robots.txt、使用条款和适用的数据使用规定。
常见问题
Q1:不限量住宅代理真的不限流量吗?
不限量主要指不按 GB 计算流量费用,但带宽仍取决于购买的 Mbps 档位,并可能受到并发数、节点数量和 Fair Use Policy 等限制。
Q2:大模型训练一定要用住宅代理吗?
不一定。公开、低风控的数据源可以使用数据中心代理;需要较高地区真实性或面临较严格 IP 风控时,可以考虑住宅代理。
Q3:动态住宅和静态住宅怎么选?
大规模网页采集通常更适合动态住宅;
需要长期保持固定出口 IP 或 Session 的任务,可以考虑静态住宅。
Q4:使用住宅代理就能绕过 Cloudflare 吗?
住宅代理只能解决部分 IP 层面的访问问题,并不能单独决定 Cloudflare 的验证结果。
Cloudflare 等系统还会结合 Bot 行为、浏览器特征、请求模式等因素判断访问。代理只是数据采集架构的一部分。
IPDeep 为合法、合规的公开 Web 数据采集提供稳定的网络出口和高吞吐代理基础设施。
如需规划大模型训练的数据采集管线,或评估不限量住宅代理的实际带宽表现,可访问IPDeep 官网获取详细信息。